Ripgrep und reguläre Ausdrücke in der Praxis
Ripgrep (rg) gehört für mich zu den nützlichsten Werkzeugen bei der
Arbeit mit größeren Softwareprojekten. Besonders wenn ich fremden oder
KI-generierten C/C++-Code untersuche, möchte ich schnell herausfinden, wo
bestimmte Funktionen verwendet werden, welche Dateien betroffen sind oder
ob ähnliche Konstruktionen mehrfach vorkommen.
Die Stärke von rg liegt in der Kombination aus hoher Geschwindigkeit,
rekursiver Dateisuche und regulären Ausdrücken.
Einfache Suchen
Eine gewöhnliche Suche im aktuellen Verzeichnis:
rg 'moveItemsOneTile'
Nur im Quellcodeverzeichnis suchen:
rg 'moveItemsOneTile' src/
Mit Zeilennummern und drei Zeilen Kontext:
rg -n -C 3 'moveItemsOneTile' src/
Nur die Namen der betroffenen Dateien ausgeben:
rg -l 'moveItemsOneTile' src/
Mit -t lassen sich bestimmte Dateitypen auswählen:
rg -t cpp 'moveItemsOneTile'
Die verfügbaren Dateitypen zeigt:
rg --type-list
Wörtliche Suche mit -F
Nicht immer benötige ich reguläre Ausdrücke. Wenn ich beispielsweise nach einem konkreten Dateinamen suche, verwende ich:
rg -F 'config.json'
Ohne -F hätte der Punkt eine besondere Bedeutung: Er steht in regulären
Ausdrücken für ein beliebiges Zeichen.
Das entsprechende Regex-Muster müsste deshalb lauten:
rg 'config\.json'
-F ist besonders bei Funktionsnamen, Fehlermeldungen und Pfaden
praktisch, weil ich mir keine Gedanken über Regex-Sonderzeichen machen
muss.
Die wichtigsten Regex-Ausdrücke
Die folgenden Konstruktionen reichen für einen großen Teil meiner täglichen Arbeit:
| Muster | Bedeutung |
|---|---|
. |
Beliebiges Zeichen außer Zeilenumbruch |
^ |
Zeilenanfang |
$ |
Zeilenende |
\b |
Wortgrenze |
\s |
Whitespace, auch Leerzeichen und Tabs |
\t |
Tabulator |
\d |
Ziffer |
[0-9] |
Ziffer zwischen 0 und 9 |
[abc] |
Eines der Zeichen a, b oder c |
[^abc] |
Jedes Zeichen außer a, b oder c |
* |
Null oder mehr Wiederholungen |
+ |
Eine oder mehr Wiederholungen |
? |
Null oder eine Wiederholung |
{3} |
Genau drei Wiederholungen |
{2,5} |
Zwei bis fünf Wiederholungen |
(a|b) |
Alternative: a oder b |
Beispielsweise findet
rg '^\s*if\s*\(' src/
Zeilen, die nach optionalen Leerzeichen oder Tabulatoren mit einer
if-Anweisung beginnen. Das Muster funktioniert unabhängig davon, wie
viele Leerzeichen zwischen if und der öffnenden Klammer stehen.
Wortgrenzen verwenden
Wenn ich nach einer Variablen namens item suche, möchte ich nicht
unbedingt auch itemCount oder items finden.
rg '\bitem\b' src/
Dafür gibt es auch die Kurzform:
rg -w 'item' src/
Bei einer Suche nach C++-Bezeichnern sind Wortgrenzen besonders hilfreich.
Die Groß-/Kleinschreibung lässt sich mit -i ignorieren:
rg -i 'readmap' src/
Mit -S verwendet rg eine intelligente Unterscheidung: Enthält das
Suchmuster Großbuchstaben, wird die Schreibweise beachtet; andernfalls
nicht.
Gruppen und Alternativen
Oft möchte ich mehrere verwandte Funktionen gleichzeitig finden. Beispielsweise:
rg 'Game::(readMap|writeMap|saveMap|loadMap)' src/
Der Ausdruck sucht nach allen vier Methoden.
Auch für Kommentare eignet sich diese Technik:
rg -n 'TODO|FIXME|HACK|XXX' src/
Gruppen sind außerdem bei optionalen Bestandteilen hilfreich:
rg '\bcolors?\b' src/
Das findet sowohl color als auch colors.
Wiederholungen
Mit Wiederholungsoperatoren kann ich variable Textstrukturen beschreiben. Beispielsweise eine vierstellige Zahl:
rg '\b[0-9]{4}\b'
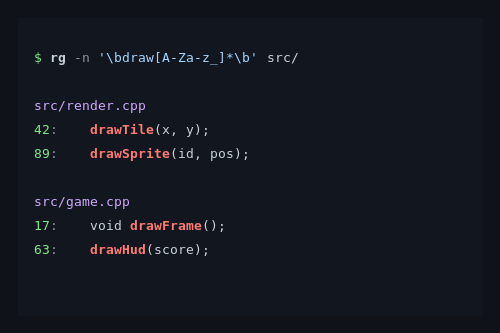
Oder einen Bezeichner, der mit draw beginnt:
rg '\bdraw[A-Za-z_0-9]*\b' src/
Dabei bedeutet der Stern, dass nach draw beliebig viele der angegebenen
Zeichen folgen dürfen.
Der Unterschied zwischen * und + ist wichtig:
rg 'foo\s*bar'
rg 'foo\s+bar'
Der erste Ausdruck erlaubt auch foobar ohne Leerzeichen. Der zweite
verlangt mindestens ein Whitespace-Zeichen.
Funktionen im C++-Code suchen
Eine typische Aufgabe besteht darin, alle Verwendungen einer Funktion zu finden.
rg -n '\bmoveItemsOneTile\s*\(' src/
Das findet den Funktionsnamen mit einer nachfolgenden öffnenden Klammer, unabhängig von den Leerzeichen dazwischen.
Eine Suche nach qualifizierten Methoden:
rg -n 'Game::[A-Za-z_][A-Za-z_0-9]*\s*\(' src/
Damit finde ich beispielsweise Game::readMap oder Game::update.
Allerdings unterscheidet rg nicht zuverlässig zwischen Definitionen,
Deklarationen und Aufrufen. Für die tatsächliche C++-Symbolnavigation
verwende ich deshalb RTags.
Regex ist eine Textsuche, kein vollständiger C++-Parser.
Mehrzeilige Suche
Normalerweise durchsucht rg jede Zeile einzeln. Bei Konstruktionen wie
if (ready)
{
    start();
}
kann das problematisch sein.
Mit -U aktiviere ich die mehrzeilige Suche:
rg -U 'if\s*\(ready\)\s*\{' src/
Damit wird auch eine öffnende Klammer in der nächsten Zeile gefunden.
Zu beachten ist, dass der Punkt auch mit -U nicht automatisch
Zeilenumbrüche erfasst. Für solche Fälle gibt es beispielsweise den
Ausdruck (?s:.*?).
Bei komplexen C++-Strukturen sollte man mehrzeilige Regex-Suchen vorsichtig verwenden.
Suchergebnisse eingrenzen
Bei größeren Projekten möchte ich Build-Verzeichnisse oder fremde Bibliotheken häufig ausschließen.
rg 'SDL_Renderer' -g '!build/**'
Nur bestimmte Dateiendungen durchsuchen:
rg 'SDL_Renderer' -g '*.cpp' -g '*.hpp'
Mit -o werden ausschließlich die Treffer ausgegeben:
rg -o 'Game::[A-Za-z_][A-Za-z_0-9]*' src/main.cpp
In Verbindung mit Unix-Werkzeugen lassen sich daraus einfache Auswertungen erstellen:
rg -o 'Game::[A-Za-z_][A-Za-z_0-9]*' src/main.cpp | sort -u
Damit erhalte ich eine Liste unterschiedlicher Methodennamen.
Zu beachten ist, dass rg standardmäßig die Regeln aus .gitignore
berücksichtigt. Wenn Dateien scheinbar fehlen, sollte man auch die
Ignorierregeln prüfen.
rg zum Durchsuchen von Hilfetexten
Eine weitere praktische Anwendung ist das Durchsuchen langer Hilfetexte.
Wenn ich beispielsweise den Parameter -F in der Hilfe von rg suche:
rg --help | rg -n -A 8 -- '^[ \t]*-F,'
Das Muster sucht nach einem eingerückten Optionseintrag, der mit -F,
beginnt. -A 8 zeigt zusätzlich acht nachfolgende Zeilen.
Der doppelte Bindestrich -- kennzeichnet das Ende der
Kommandozeilenoptionen. Dadurch lassen sich auch Suchmuster verwenden, die
mit einem Bindestrich beginnen.
Wenn ich den langen Optionsnamen kenne, kann ich einfacher suchen:
rg --help | rg -C 3 -F -- '--fixed-strings'
In einer Manpage kann ich mit / nach einem Begriff suchen und
anschließend mit n beziehungsweise N zwischen den Treffern wechseln.
Reguläre Ausdrücke und die Shell
Ich schreibe meine Suchmuster normalerweise zwischen einfache Anführungszeichen:
rg '^\s*if\s*\(' src/
Damit verhindert man, dass die Shell Sonderzeichen vorzeitig interpretiert.
Bei bekannten Zeichenketten aus Shell-Variablen verwende ich bevorzugt
-F:
suchtext='Game::readMap'
rg -F -- "$suchtext" src/
Das ist einfacher und weniger fehleranfällig.
Grenzen von regulären Ausdrücken
Ripgrep verwendet standardmäßig eine schnelle Regex-Engine, die bestimmte erweiterte Konstruktionen nicht unterstützt. Dazu gehören Look-ahead, Look-behind und Rückreferenzen im Suchmuster.
Wenn ripgrep mit PCRE2-Unterstützung kompiliert wurde, kann ich dafür -P
verwenden:
rg -P 'foo(?=bar)' src/
Das findet foo, wenn unmittelbar danach bar steht.
Für die meisten Aufgaben ist die normale Regex-Engine aber vollkommen ausreichend.
Außerdem gilt: Reguläre Ausdrücke können keine vollständige Analyse einer Programmiersprache ersetzen. Gerade bei Templates, Makros und verschachtelten C++-Konstruktionen stößt die Textsuche an ihre Grenzen.
Mein praktischer Arbeitsablauf
Bei der Untersuchung von C++-Projekten verwende ich die Werkzeuge inzwischen für unterschiedliche Aufgaben:
| Werkzeug | Aufgabe |
|---|---|
rg |
Textstellen und Muster schnell finden |
| RTags | Definitionen und Referenzen untersuchen |
| Lizard | Komplexe und überlange Funktionen erkennen |
| Emacs | Quellcode lesen und bearbeiten |
Wenn Lizard beispielsweise eine Funktion mit hoher zyklomatischer
Komplexität meldet, suche ich zunächst mit rg nach ihrem Namen:
rg -n -F 'moveItemsOneTile' src/
Anschließend lasse ich mir die Fundstellen mit Kontext anzeigen:
rg -n -C 5 -F 'moveItemsOneTile' src/
Für die weitere Untersuchung wechsle ich zu Emacs und RTags.
Der Vorteil dieser Arbeitsweise liegt darin, dass ich nicht sofort das gesamte Projekt verstehen muss. Ich kann mich schrittweise von einer konkreten Fragestellung zu den relevanten Quellcodestellen vorarbeiten.
Fazit
Die wichtigste Erkenntnis bei der Verwendung von rg ist, dass nicht jede
Suche einen komplizierten regulären Ausdruck benötigt.
Für bekannte Zeichenketten verwende ich -F. Für variable Schreibweisen
nutze ich Wortgrenzen, Zeichenklassen, Wiederholungen und Gruppen. Mit
-g, -C und -l kann ich die Ergebnismenge gezielt einschränken.
Besonders nützlich finde ich die Kombination mit klassischen
Unix-Werkzeugen wie sort, uniq und awk.
Wer diese wenigen Möglichkeiten beherrscht, kann auch große Softwareprojekte wesentlich schneller untersuchen, ohne dafür eine umfangreiche Entwicklungsumgebung zu benötigen.